Dũng Virgo
Một văn bản do ChatGPT tạo ra có thể không để lộ dấu hiệu bất thường khi được đọc bằng mắt thường. Tuy nhiên, trong thời gian tới, các nội dung như vậy tại Liên minh châu Âu có thể mang theo một tín hiệu kỹ thuật vô hình, cho phép hệ thống chuyên dụng kiểm tra nguồn gốc của chúng.

OpenAI cho biết sẽ bắt đầu triển khai watermark dạng văn bản cho ChatGPT và Codex tại EU trong vài tuần tới. Động thái này gắn với yêu cầu về tính minh bạch trong EU AI Act, theo đó nội dung được tạo hoặc xử lý bởi AI cần có cơ chế để các hệ thống khác nhận diện.
Watermark không phải biểu tượng nhìn thấy trên màn hình
Khác với logo, dòng chú thích hay ký hiệu được chèn trực tiếp vào tài liệu, watermark của OpenAI sẽ không xuất hiện dưới dạng hình ảnh hoặc văn bản dễ nhận biết. Người dùng vẫn nhìn thấy một đoạn nội dung bình thường, không có dấu hiệu rõ ràng cho biết nó được tạo bởi ChatGPT.
Thay vào đó, mô hình sẽ điều chỉnh rất nhỏ cách lựa chọn từ trong quá trình sinh câu. Mỗi thay đổi riêng lẻ gần như không đáng kể, nhưng khi được lặp lại đủ nhiều lần trong một văn bản, chúng tạo thành một mẫu thống kê đặc trưng.
Công cụ phát hiện có khóa và phương pháp phân tích phù hợp có thể tìm kiếm mẫu này để đánh giá liệu văn bản có khả năng được tạo bởi hệ thống OpenAI hay không. Vì tín hiệu nằm trong cách sắp xếp từ, nó có thể tiếp tục tồn tại khi người dùng sao chép và dán nội dung sang một tài liệu hoặc nền tảng khác.
OpenAI khẳng định công nghệ này không được thiết kế để xác định danh tính người viết hay truy ngược tài khoản đã tạo ra văn bản. Công ty cũng cho biết chưa nhận thấy ảnh hưởng đáng kể đến hiệu năng của mô hình khi watermark được bật.
textGrain tạo “dấu vân tay” bằng khóa bí mật
Hệ thống đứng sau cơ chế này có tên textGrain. OpenAI phát triển công nghệ cùng các nhà nghiên cứu đến từ Đại học Pennsylvania và Đại học Yale.
Về nguyên lý, mô hình ngôn ngữ luôn phải lựa chọn từ tiếp theo dựa trên ngữ cảnh và xác suất. textGrain sử dụng một khóa bí mật để sắp xếp những lựa chọn đó theo cách có chủ đích. Mô hình vẫn tạo ra câu có ý nghĩa và tự nhiên, nhưng chuỗi lựa chọn từ sẽ chứa các tín hiệu thống kê mà người đọc thông thường không thể nhận ra.
Có thể hình dung mỗi lựa chọn nhỏ giống như một điểm đánh dấu. Một điểm riêng lẻ không đủ để kết luận, nhưng hàng trăm điểm được tích lũy trong toàn bộ đoạn văn sẽ tạo nên “dấu vân tay” có thể kiểm tra. Cách tiếp cận này giúp watermark không cần thay đổi màu chữ, kiểu chữ hay cấu trúc hiển thị của tài liệu.
Đây cũng là lý do watermark có tiềm năng hoạt động sau thao tác sao chép. Miễn là phần lớn đặc điểm thống kê của văn bản vẫn còn, công cụ chuyên dụng có thể tìm thấy tín hiệu do hệ thống tạo ra.
Chỉnh sửa nhẹ vẫn có thể làm giảm độ chính xác
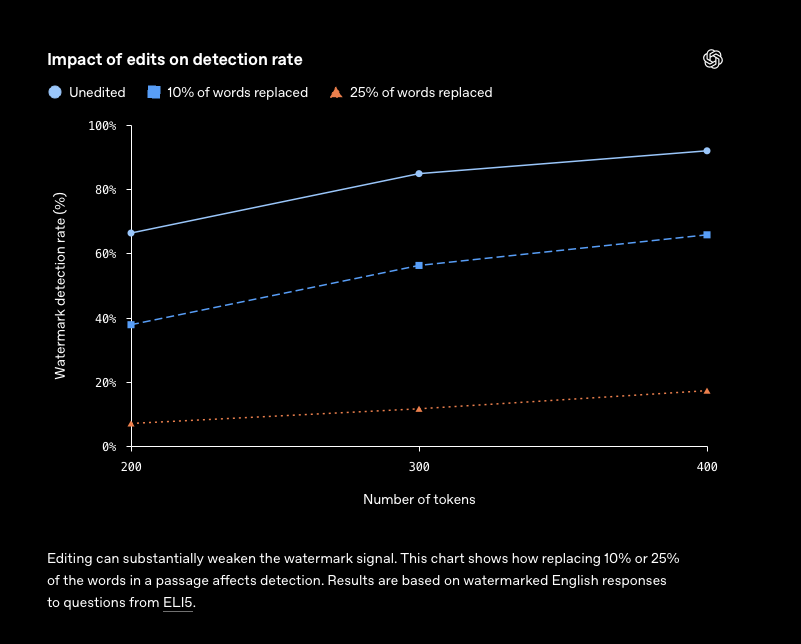
Watermark không phải bằng chứng tuyệt đối và cũng không bất khả xâm phạm. Trong các thử nghiệm được OpenAI công bố, việc thay khoảng 10% số từ bằng từ đồng nghĩa đã khiến khả năng phát hiện giảm từ khoảng 92% xuống còn 66%.
Điều này tạo ra một giới hạn quan trọng trong thực tế. Một người dùng có thể viết lại một số câu, thay đổi cách diễn đạt, bổ sung ý kiến cá nhân hoặc nhờ một công cụ khác biên tập văn bản. Những thay đổi đó có thể làm suy yếu mẫu thống kê ban đầu, dù nội dung vẫn dựa phần lớn vào bản nháp do ChatGPT tạo ra.
Hiệu quả nhận diện cũng kém ổn định hơn trong một số tình huống:
- Đoạn văn quá ngắn không có đủ số lượng tín hiệu để tạo thành mẫu đáng tin cậy.
- Câu trả lời toán học thường có cấu trúc hạn chế, khiến mô hình ít cơ hội lựa chọn từ theo cách watermark yêu cầu.
- Văn bản đã được dịch sang ngôn ngữ khác có thể mất hoặc biến dạng các đặc điểm ban đầu.
- Nội dung được tạo bởi một hệ thống AI khác sẽ không nhất thiết mang watermark của OpenAI.
Vì vậy, nếu một công cụ không tìm thấy watermark, kết quả đó không đồng nghĩa văn bản chắc chắn do con người viết. Nội dung có thể quá ngắn, đã qua chỉnh sửa nhiều lần hoặc chưa từng được tạo bởi ChatGPT và Codex.
OpenAI chưa mở công cụ phát hiện cho mọi người
Dù chuẩn bị triển khai watermark, OpenAI hiện chưa cung cấp công cụ phát hiện đại trà. Quyền truy cập đang được giới hạn cho các nhà nghiên cứu và tổ chức chuyên môn được phê duyệt.
Cách tiếp cận thận trọng này phản ánh những rủi ro của việc sử dụng bộ phát hiện như một “máy phán quyết”. Nếu kết quả nhận diện bị xem là kết luận chắc chắn, người dùng có thể bị đánh giá sai trong các bối cảnh như giáo dục, tuyển dụng, xuất bản hoặc kiểm duyệt nội dung.
Một đoạn văn do con người viết nhưng ngắn, đơn giản hoặc đã được dịch có thể bị đánh giá không chính xác. Ngược lại, văn bản AI đã được chỉnh sửa đủ nhiều có thể không còn để lộ tín hiệu. Do đó, watermark phù hợp hơn với vai trò một lớp dữ liệu hỗ trợ điều tra nguồn gốc, thay vì bằng chứng duy nhất để kết luận về tác giả.
Vấn đề này tương tự những tranh luận rộng hơn về quyền riêng tư và dấu vết kỹ thuật của các công cụ AI. Người dùng cũng cần hiểu rằng việc sử dụng một chatbot không đồng nghĩa mọi nội dung trao đổi đều là nhật ký riêng tư tuyệt đối. Một trường hợp liên quan đến Claude cho thấy dữ liệu hội thoại có thể trở thành nguồn thông tin quan trọng trong những hoàn cảnh đặc biệt.
Watermark không đo được đóng góp của con người
Một câu hỏi khó hơn vẫn chưa được giải quyết: con người đã đóng góp bao nhiêu vào văn bản?
Watermark có thể giúp chỉ ra rằng một đoạn nội dung được tạo hoặc xử lý bởi hệ thống OpenAI. Tuy nhiên, nó không thể biết người dùng chỉ nhập một yêu cầu ngắn rồi sao chép toàn bộ câu trả lời, hay đã tự nghiên cứu, kiểm chứng, biên tập và viết lại phần lớn nội dung.
Hai tài liệu có thể cùng mang tín hiệu AI nhưng mức độ tham gia của con người hoàn toàn khác nhau. Một bài luận được AI tạo gần như toàn bộ không thể được đánh đồng với một bản thảo do người viết xây dựng, trong đó ChatGPT chỉ hỗ trợ sửa lỗi chính tả hoặc gợi ý cách trình bày.
Đây là lý do watermark không thể tự mình thay thế quy trình đánh giá của giáo viên, biên tập viên, nhà tuyển dụng hay cơ quan quản lý. Nó cung cấp thêm thông tin về nguồn gốc kỹ thuật, nhưng không phản ánh chất lượng lập luận, tính trung thực, mức độ sáng tạo hay trách nhiệm của người sử dụng.
Vì sao EU trở thành nơi triển khai đầu tiên?
OpenAI từng phát triển công nghệ watermark văn bản nhưng trì hoãn việc phát hành. Một trong những lo ngại khi đó là người dùng có thể chuyển sang các dịch vụ cạnh tranh không áp dụng cơ chế đánh dấu nội dung.
EU AI Act đã tạo ra động lực pháp lý khác. Theo kế hoạch hiện tại, watermark sẽ được triển khai cho những người dùng ChatGPT và Codex đủ điều kiện tại EU trên tất cả các gói dịch vụ. Đây là cách OpenAI đáp ứng yêu cầu minh bạch của khu vực, thay vì để người dùng hoặc từng tổ chức tự tìm phương án nhận diện.
Khách hàng sử dụng API ở bất kỳ đâu trên thế giới cũng có thể chủ động bật tính năng trên một số mô hình được hỗ trợ. Tuy nhiên, watermark vẫn tắt theo mặc định đối với nhóm này. Điều đó cho thấy chính sách triển khai được phân tách theo khu vực và loại dịch vụ, thay vì áp dụng một cấu hình giống nhau cho mọi người dùng trên toàn cầu.
Anthropic cũng chọn hướng đánh dấu nội dung AI
OpenAI không phải công ty duy nhất tìm cách tạo dấu hiệu nhận diện cho văn bản do mô hình ngôn ngữ sinh ra. Anthropic đã tuyên bố áp dụng watermark cho nội dung do Claude tạo ra trên phạm vi toàn cầu.
Những lựa chọn khác nhau giữa các công ty cho thấy ngành AI đang tìm cách cân bằng giữa tính minh bạch, quyền riêng tư và trải nghiệm người dùng. Watermark càng bền vững thì khả năng nhận diện càng cao, nhưng việc chỉnh sửa, dịch thuật và sử dụng nhiều công cụ liên tiếp vẫn có thể làm mất tín hiệu.
Bên cạnh đó, sự xuất hiện của nhiều hệ thống AI khiến việc phát hiện trở nên phức tạp hơn. Một bộ nhận diện được thiết kế cho văn bản OpenAI không thể mặc nhiên kết luận về nội dung do các nền tảng khác tạo ra. Những công cụ hỗ trợ tìm nguồn gốc tài khoản ẩn danh cũng cho thấy việc truy vết dữ liệu kỹ thuật luôn phụ thuộc vào loại dấu vết và bối cảnh cụ thể, chứ không chỉ dựa trên một thuật toán duy nhất.
Người dùng cần hiểu watermark như thế nào?
Với người dùng tại châu Âu, các văn bản tạo bằng ChatGPT trong thời gian tới có thể mang theo một lớp thông tin mà mắt thường không nhìn thấy. Điều này không biến mọi nội dung AI thành thứ có thể bị phát hiện dễ dàng, nhưng làm tăng khả năng các hệ thống chuyên dụng kiểm tra nguồn gốc văn bản.
Người dùng không nên xem watermark là công cụ để “bắt quả tang” tuyệt đối. Kết quả phát hiện cần được đọc cùng lịch sử chỉnh sửa, bản nháp, nguồn tham khảo và bối cảnh tạo nội dung. Đặc biệt, không nên dùng việc không phát hiện thấy watermark để khẳng định một văn bản hoàn toàn do con người viết.
Ở góc độ rộng hơn, cơ chế này đánh dấu một bước chuyển trong cách ngành công nghệ xử lý nội dung AI. Khi văn bản do máy tạo ngày càng phổ biến, trách nhiệm không chỉ nằm ở việc tạo ra câu chữ tự nhiên, mà còn ở khả năng minh bạch hóa nguồn gốc và giới hạn của công cụ.
Watermark của OpenAI vì thế có thể xem là một lớp xác thực bổ sung, không phải lời giải cuối cùng cho bài toán phân biệt người và máy. Nó giúp các tổ chức có thêm dữ liệu để đánh giá, đồng thời nhắc người dùng rằng nội dung được tạo bằng AI cần được kiểm chứng, biên tập và sử dụng có trách nhiệm.
Startup Việt tiết kiệm hơn 200 triệu nhờ gói hỗ trợ Anthropic
Nga hoàn tất nguyên mẫu máy quang khắc 130 nm đầu tiên
Sharp dẫn đầu bình chọn hệ sinh thái sống khỏe tại BCA 2026
Sun Holidays giảm 10%, tối đa 1 triệu đồng qua VietQR
Hacker làm nóng tủ lạnh tại hàng trăm siêu thị Pháp
VIS 2026: Kết nối vốn, công nghệ và thị trường cho Việt Nam
Getty Images đối mặt nguy cơ phá sản sau cú rơi 99% cổ phiếu